Erste Schritte mit Console
Eine Plattform zum Erkunden, Entwickeln, Absichern und Verwalten von Kafka. Funktioniert mit Confluent, MSK, Redpanda oder einem beliebigen Kafka 2.5+.
Senden Sie diesen Prompt an Ihren Coding-Agenten. Er installiert den Skill und dann Console.
Installiere den Conduktor-Skill mit npx skills add conduktor/skills -g -y und nutze ihn dann, um Conduktor zu installieren und so einzurichten, dass ich mich anmelden kann.
Nichts geöffnet? Kopieren Sie den Prompt oben und fügen Sie ihn in Ihren Agenten ein.
Nutzt den Open-Source-Conduktor-Skill · Entdecken Sie die Möglichkeiten →
curl -fL https://releases.conduktor.io/quick-start | docker compose -f - up
Rufen Sie die Console unter localhost:8080 auf, sobald sie läuft. Enthält eingebettetes Redpanda, Schema Registry und Beispieldaten. Vollständige Docker-Installationsdokumentation →
helm repo add conduktor https://helm.conduktor.io
helm install console conduktor/console \
  -f values.yaml
kubectl port-forward deployment/console 8080:8080
Stellt Console mit dem offiziellen Helm-Chart bereit, mit Ihrer eigenen PostgreSQL-Datenbank (in values.yaml hinterlegt). Ersetzen Sie den Port-Forward durch einen Ingress, um Console für Ihr Team freizugeben. Vollständige Kubernetes-Installationsdokumentation →
Ein CloudFormation-Stack stellt die VPC, einen ECS-Fargate-Service und eine RDS-PostgreSQL-Datenbank bereit. Sie nutzen EKS? Wechseln Sie zum Kubernetes-Tab.
Kopieren fehlgeschlagen. Markieren Sie den Text oben und kopieren Sie ihn manuell.
In die Zwischenablage kopiert
Endlich sehen, was Ihr Kafka macht
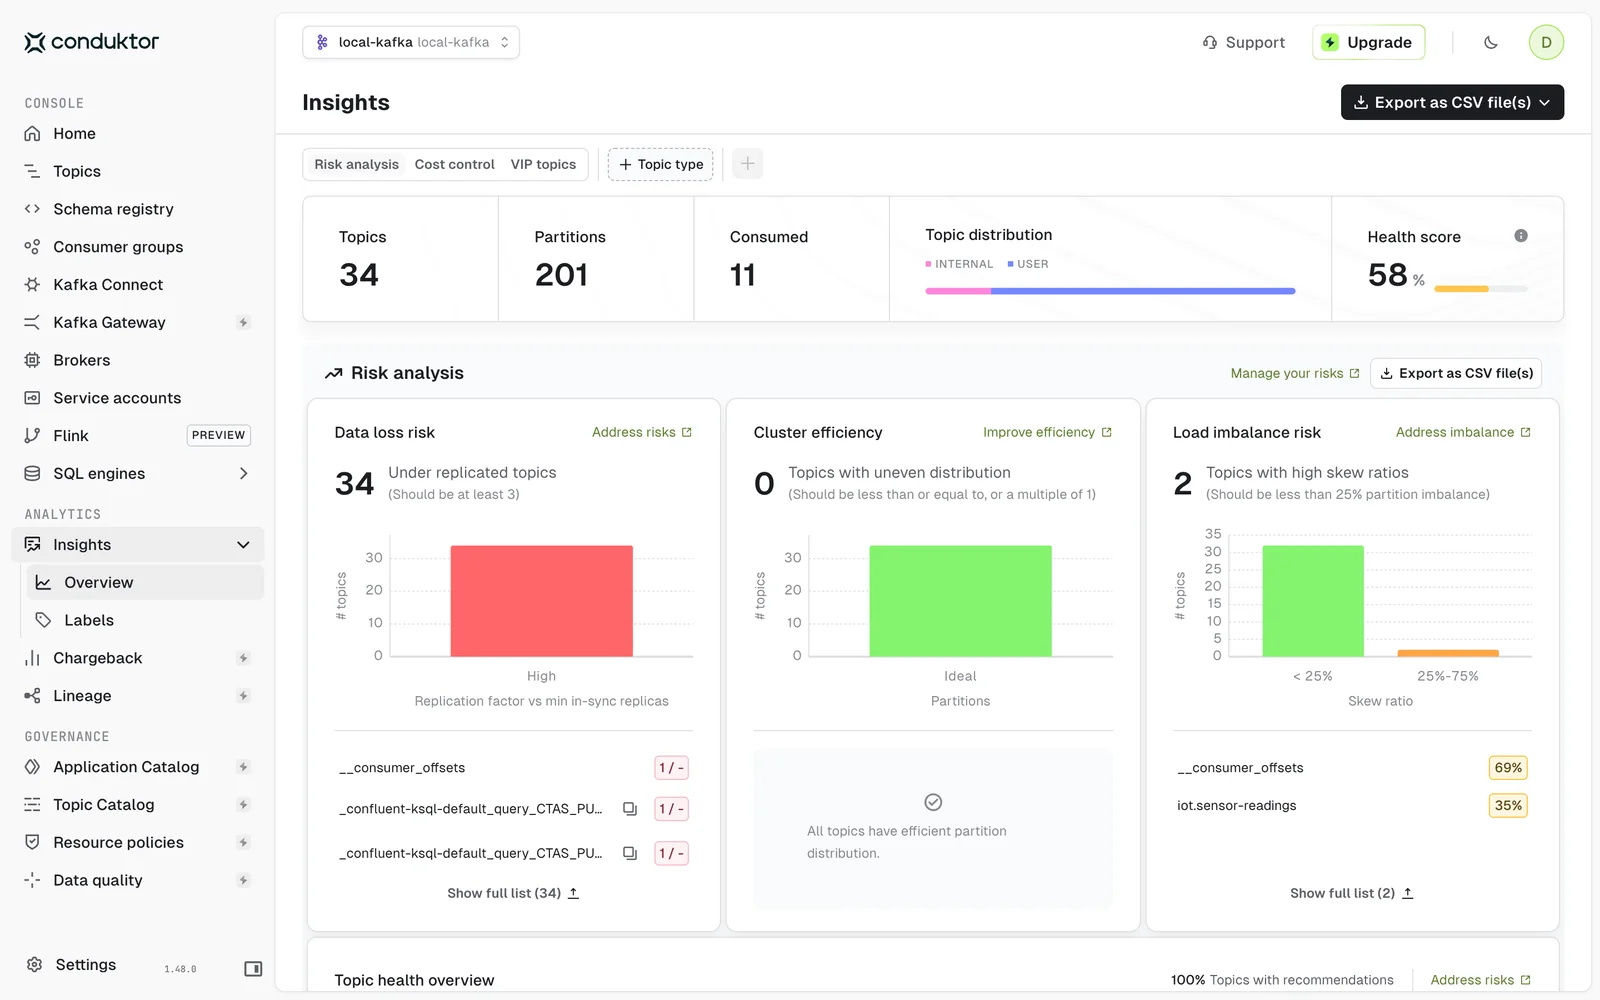 34 Topics könnten Daten verlieren
Dieser Screenshot konnte nicht geladen werden. Wählen Sie den Schritt aus, um es erneut zu versuchen.
Ein Score für den Systemzustand Ihres Clusters, und die Topics, die bei einem Broker-Ausfall Daten verlieren könnten.
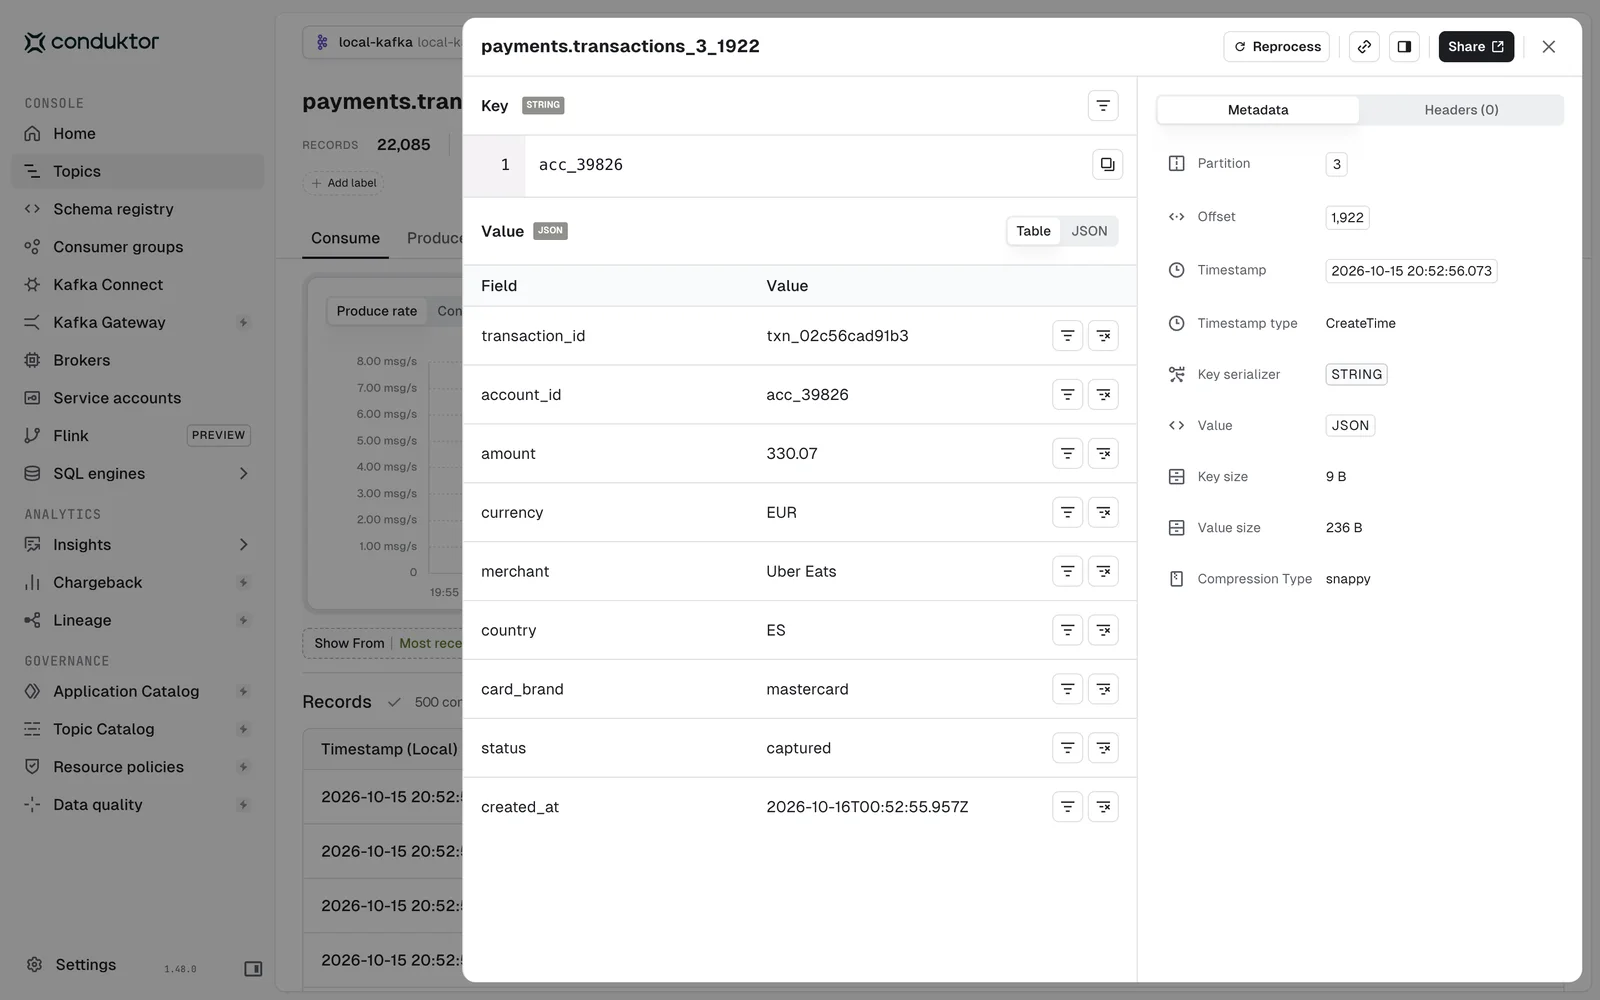
Öffnen Sie jeden Record und lesen Sie ihn Feld für Feld: JSON, Avro oder Protobuf.
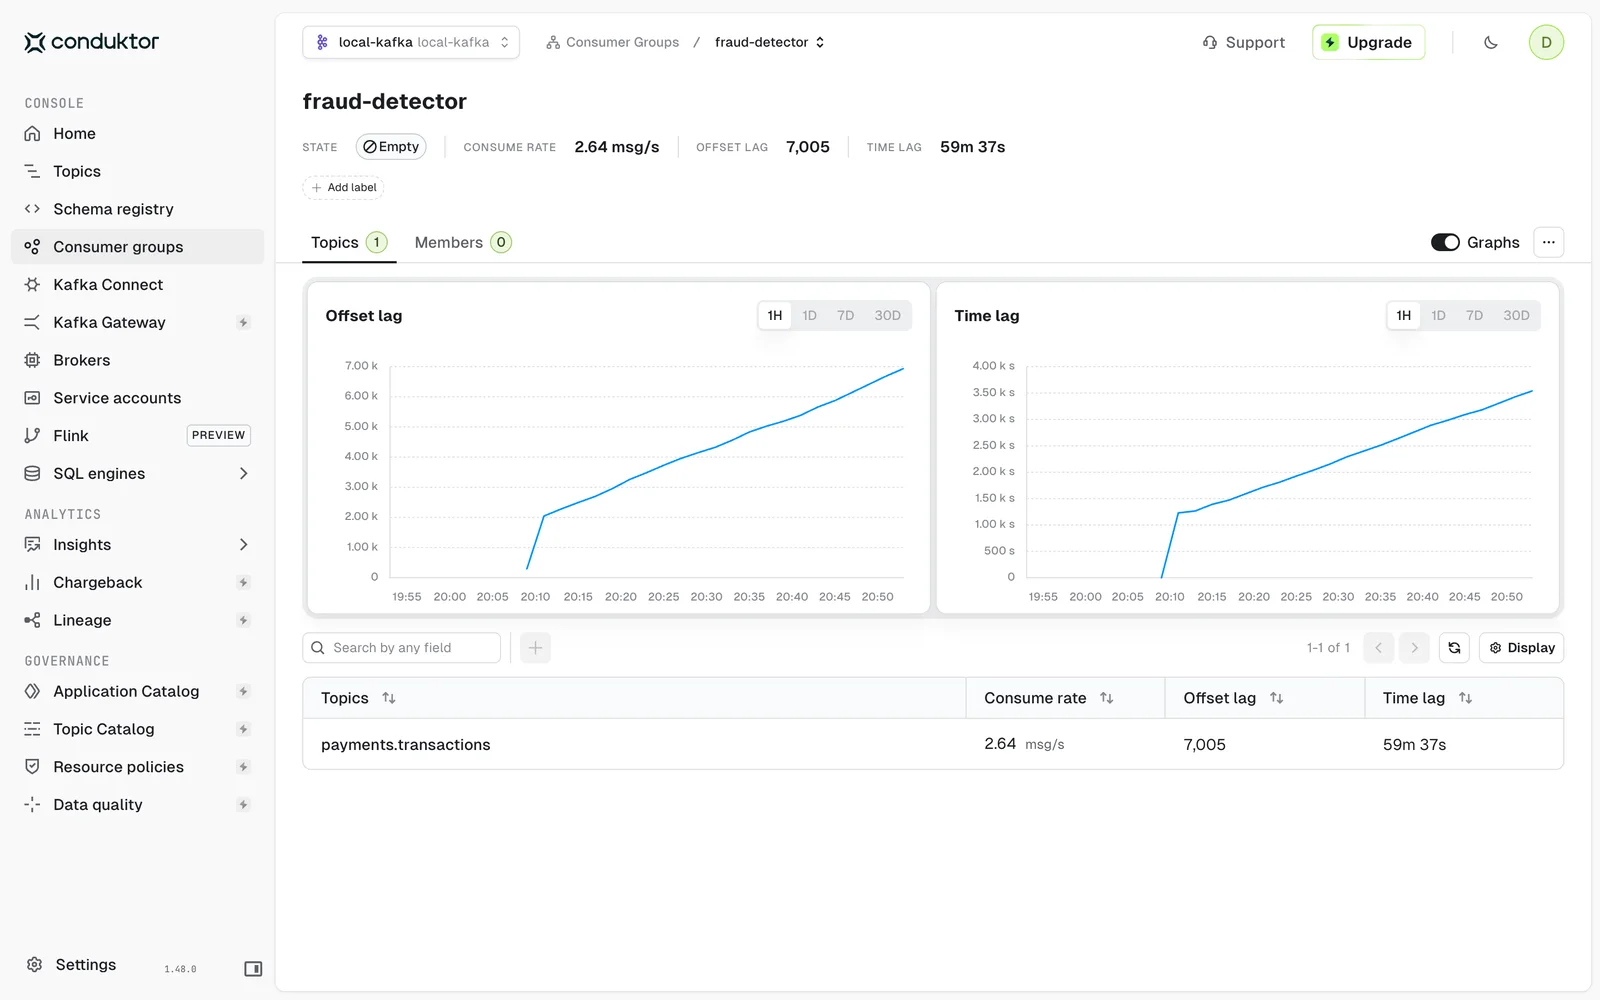
Erkennen Sie den Consumer, der stehen geblieben ist, und wie weit er zurückliegt.
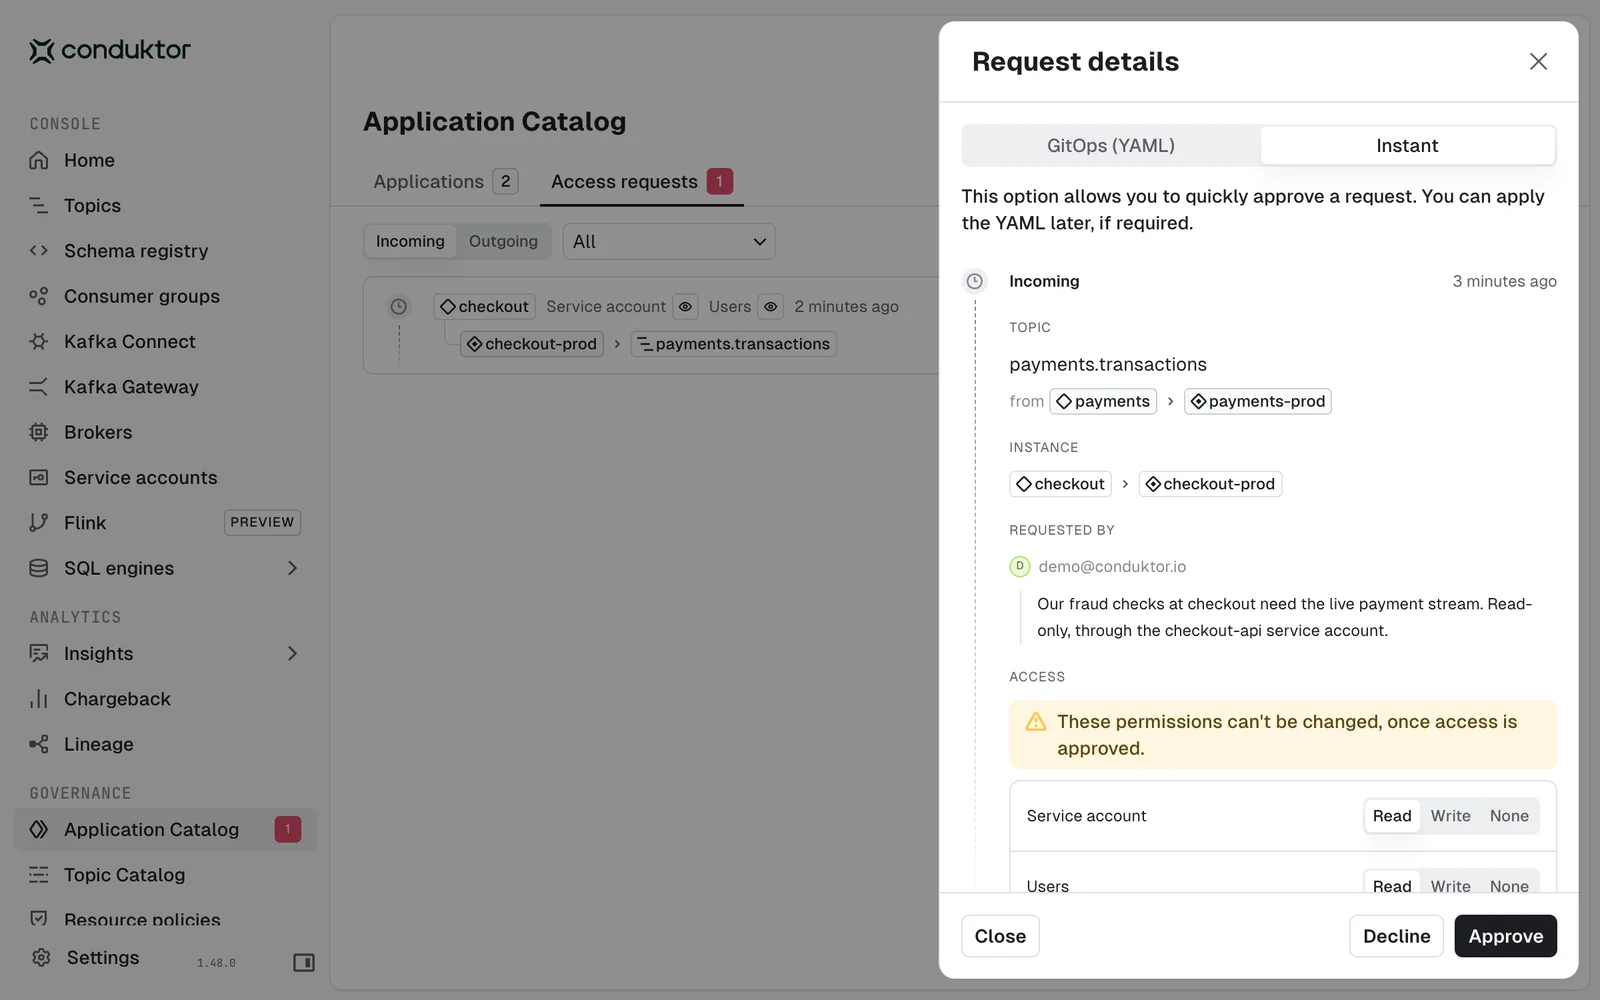
Sie brauchen Daten eines anderen Teams? Fragen Sie im Katalog an, nennen Sie den Grund, und das Team, dem die Daten gehören, genehmigt. Self-Service ist in Team Edition enthalten.
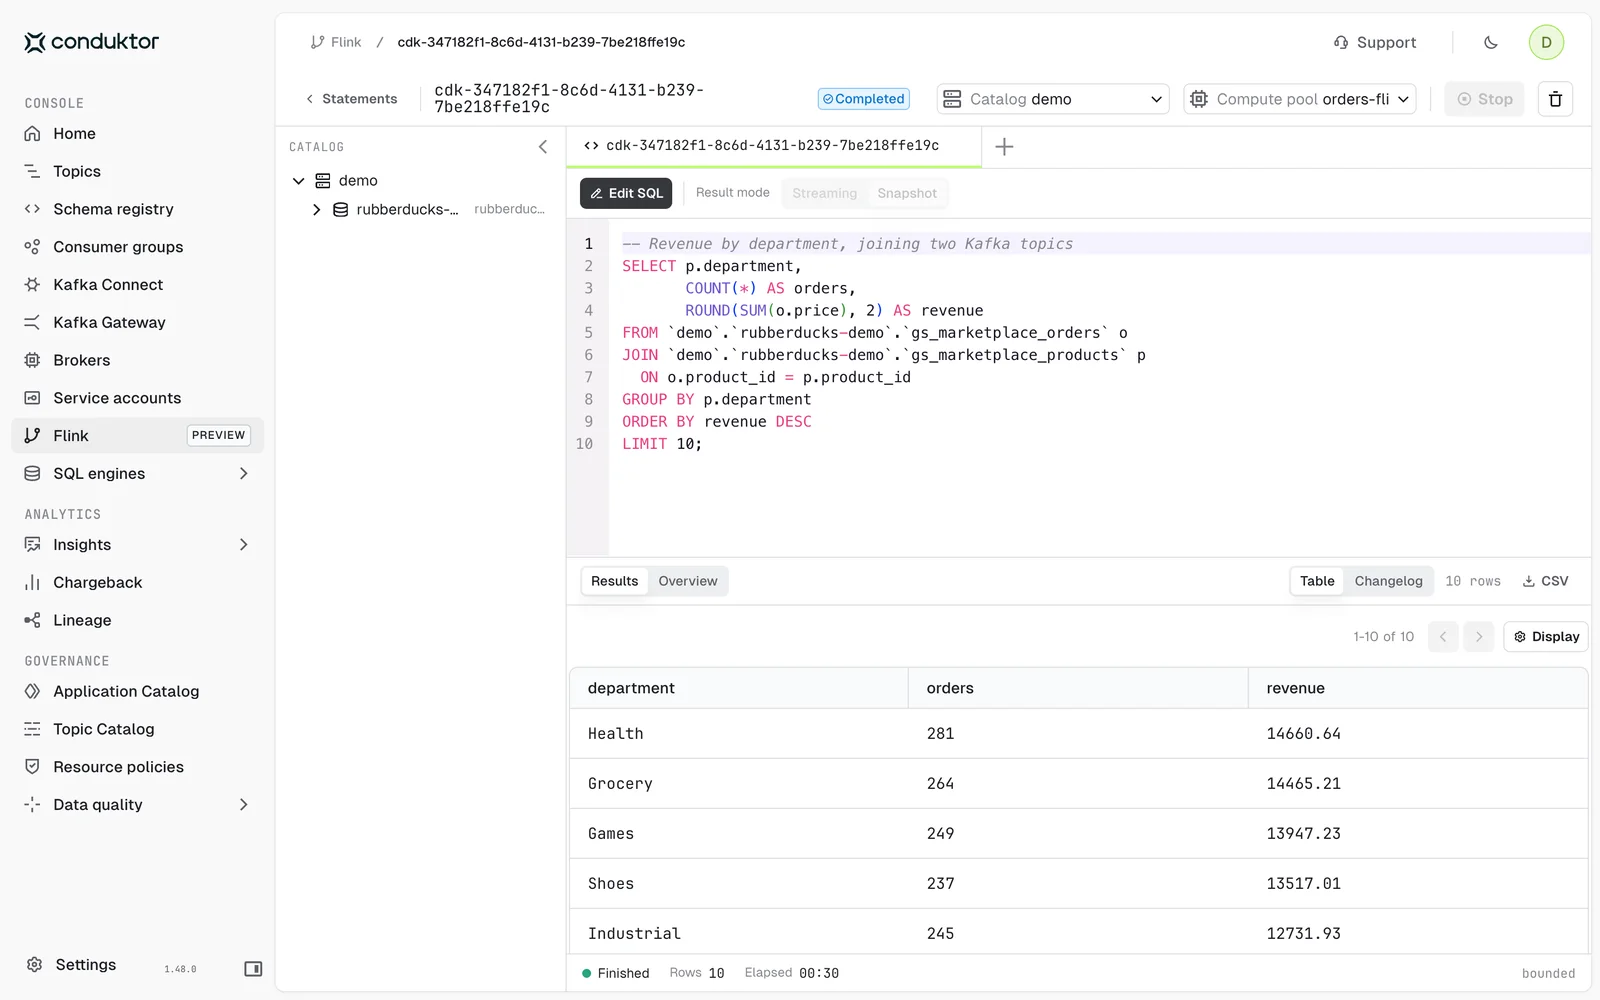
Fragen Sie Ihre Topics mit Flink SQL ab und verknüpfen Sie sie, auf Compute Pools in Confluent Cloud, mit den Berechtigungen von Console auf jedem Topic.
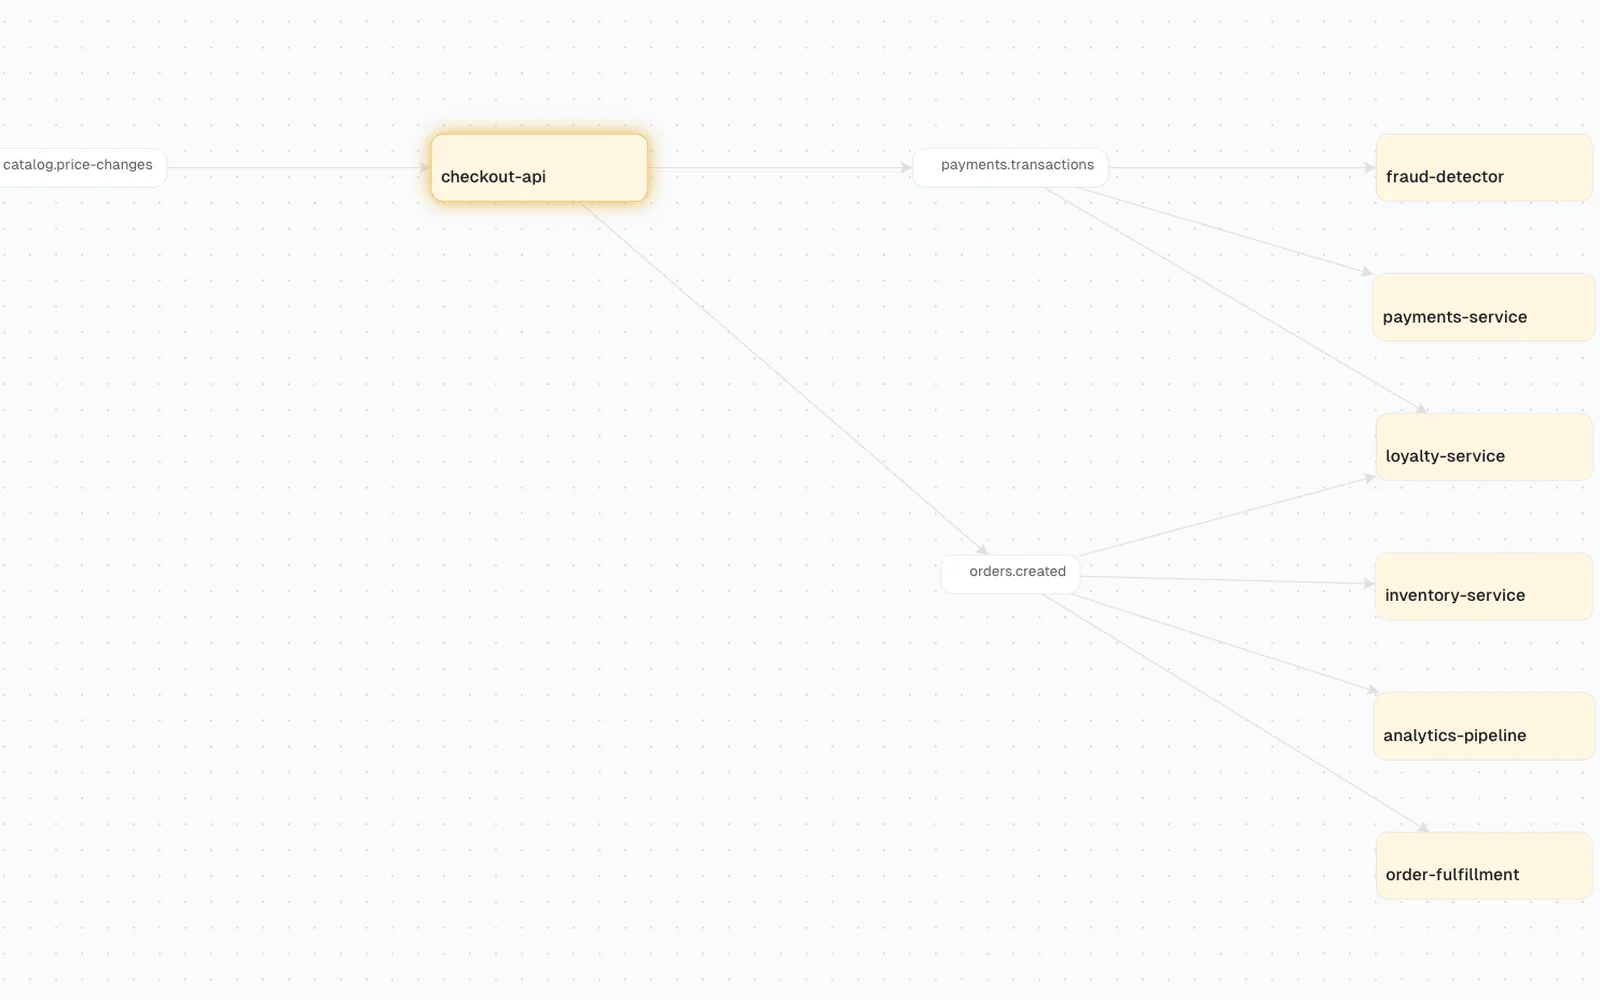
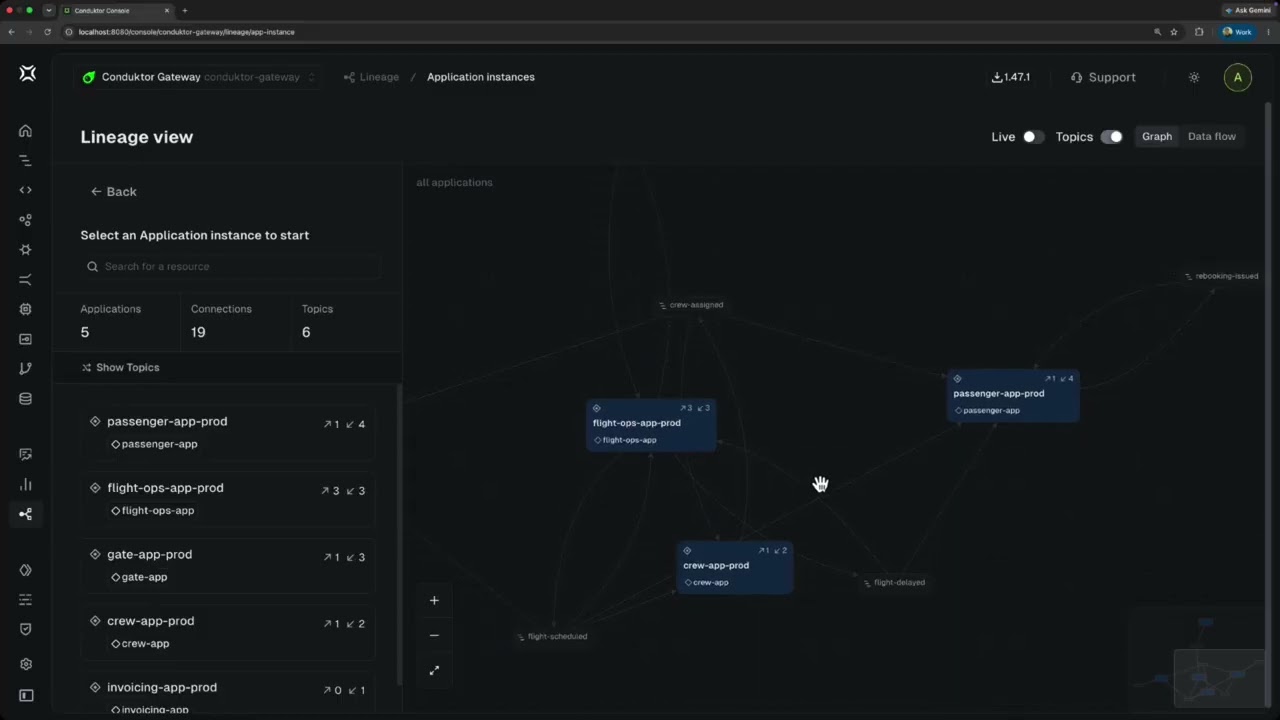
Bevor Sie ein Topic ändern, sehen Sie jeden Service, der es liest. Lineage ist in Team Edition enthalten.
Team Edition
Bereit für mehr Cluster, mehr Teams, mehr Kontrolle?
Alles aus Community, plus Governance, Automatisierung und Insights, die Teams benötigen, um Kafka in großem Maßstab zu betreiben. Self-Service, kein Verkaufsgespräch.
- Unbegrenzte Cluster
- Föderiertes Ownership & Genehmigungs-Workflows
- Durchsetzung von Topic-Richtlinien
- Kostenverrechnung & erweiterte Insights
- RBAC auf Gruppenebene
- Unbegrenzte Audit Logs & Benachrichtigungen
Produkt-Demos ansehen
Erleben Sie Conduktor in Aktion mit kurzen Video-Walkthroughs.
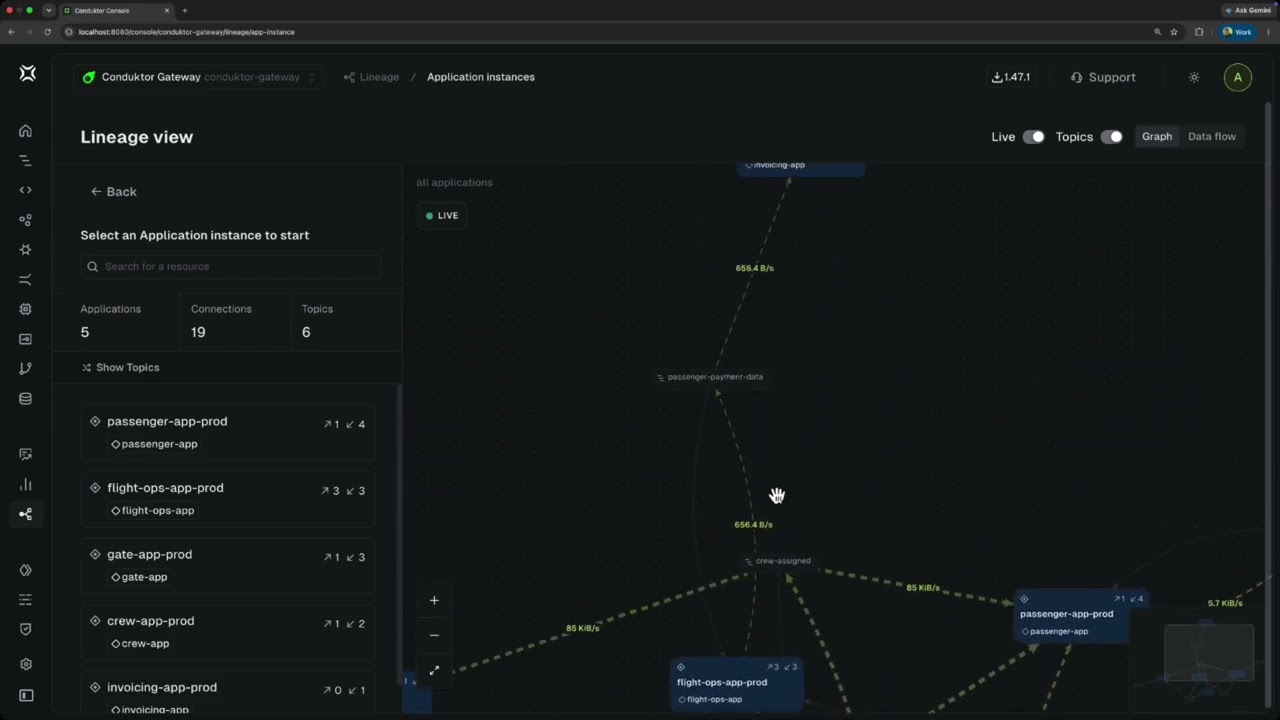
Gehen Sie die Abhängigkeitskarte Ihrer Kafka-Landschaft in Console durch: Ansichten nach Anwendung und Service Account, Live-Traffic, Detailanalyse Hop für Hop und die Consumer, die niemand registriert hat.
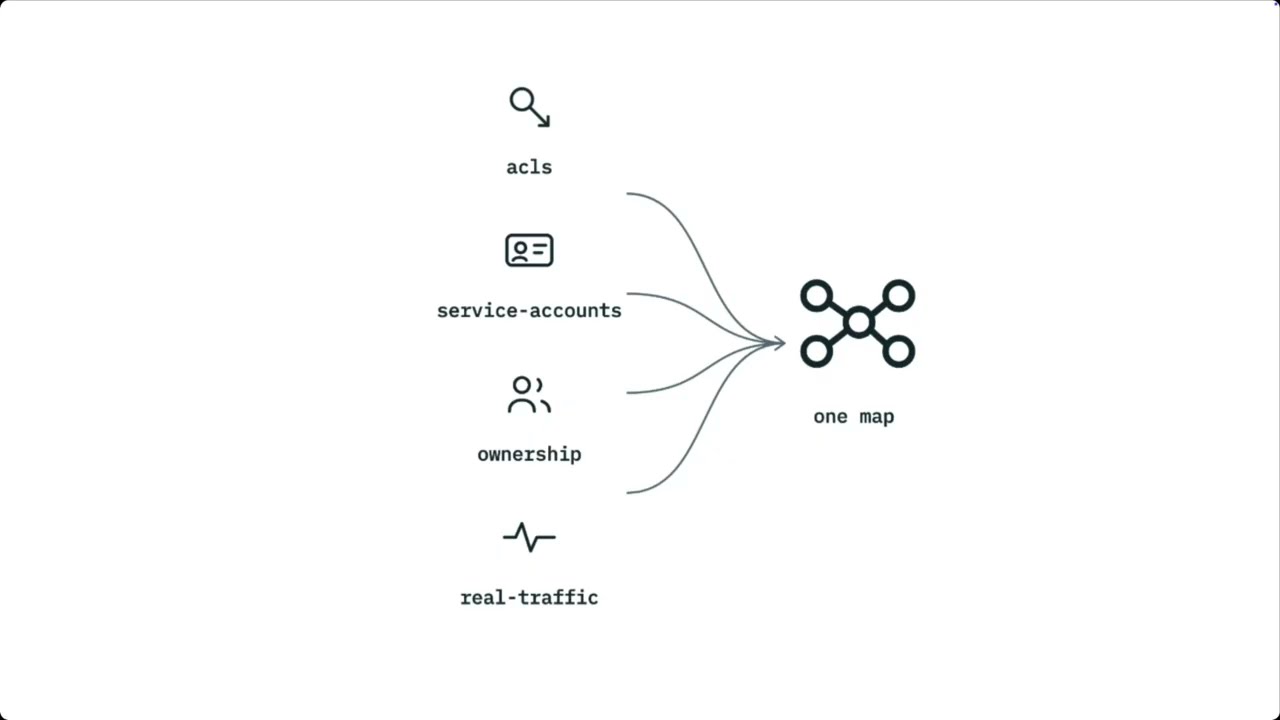
Einen Topic abschalten, einen heiß gelaufenen Pfad finden und einen nicht registrierten Consumer in der Kafka-Landschaft einer Airline aufspüren – mit einer Abhängigkeitskarte aus ACLs, Ownership-Modell und Live-Traffic über das Gateway.
Ein Team onboarden, einen Topic abschalten, eine heiß gelaufene Verbindung verfolgen: Alle drei brauchen dieselben drei Antworten, und die meisten Teams bekommen sie, indem sie herumfragen. Warum die Abhängigkeitskarte so schwer zu bauen ist.
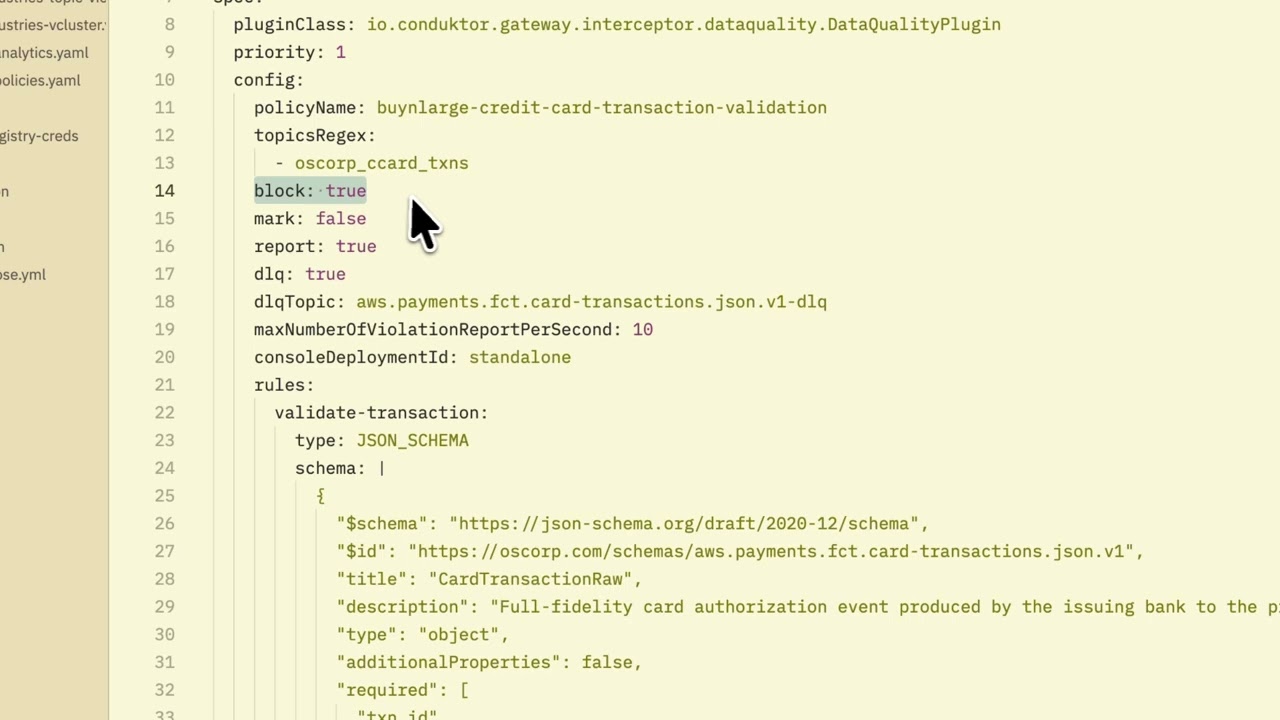
Weisen Sie fehlerhafte Kafka-Records schon beim Produzieren ab, mit den Datenqualitätsrichtlinien von Gateway: JSON-Schema- oder CEL-Regeln plus einem Dead-Letter-Topic, das der Producer debuggen kann.
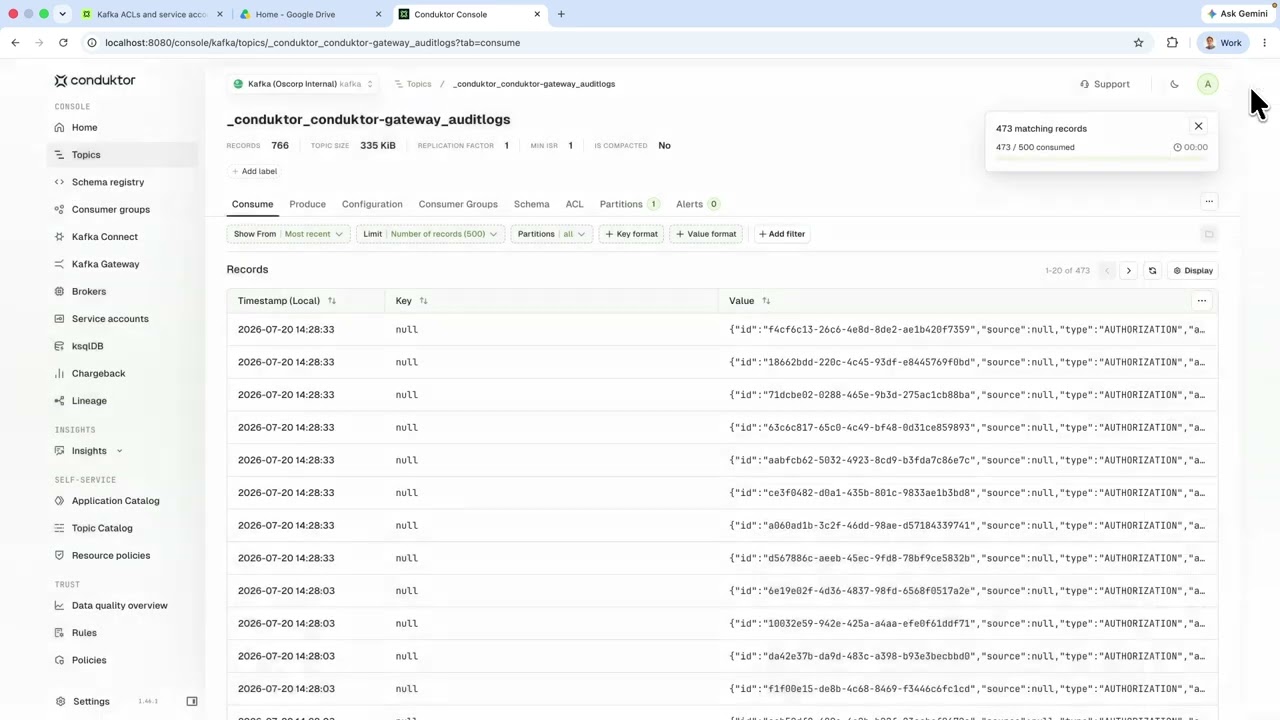
Conduktor Gateway speichert seinen Zustand in Kafka-Topics. Ein Blick auf ACLs pro virtuellem Cluster, das Audit-Log, Interceptor-Konfigurationen und die Byte-Abrechnung pro Partner.




"Als QA-/Automatisierungsmanager liegt mein Fokus auf der nahtlosen Verbindung der Tools, die den Tech-Stack meiner Organisation bilden. Die Benutzeroberfläche von Conduktor ist elegant, intuitiv und verbessert das Kafka-Management erheblich durch eine visuell ansprechende und benutzerfreundliche Erfahrung."
QA Manager, Snappy
"Conduktor hat unser Kafka-Management grundlegend verändert. Die intuitive Oberfläche und die leistungsstarken Echtzeit-Monitoring-Tools haben unsere Abläufe optimiert und die Fehlerbehebungszeit um über 30 % reduziert. Die mächtigen Debugging-Funktionen sind für unser Team unschätzbar wertvoll."
Backend Engineer, Greentube
"Wir nutzen Conduktor seit etwa 1,5 Jahren. Zuvor haben wir versucht, unsere Kafka-Cluster über CLI/Postman zu verwalten. Das war sehr umständlich und fehleranfällig. Nachdem wir Conduktor installiert hatten, nahm unser Team es schnell an. Die Plattform hat unsere Umgebung enorm beeinflusst."
Data Analytics Team Lead, Ciceksepeti
"Von allen Kafka-Tools, die ich genutzt habe, ist Conduktor bei Weitem das einfachste in der Implementierung und bietet den umfassendsten Funktionsumfang. Als Production Support Engineer, der auf Transparenz über alle Komponenten angewiesen ist, macht Conduktor Navigation und Fehlerbehebung einfach."
Chuck
Production Support Engineer, Fermenta Energy
"Conduktor hat uns geholfen, unsere Datenströme zu visualisieren und zu verstehen – ohne die Komplexität manueller CLI-Befehle. Die Oberfläche war intuitiv und hat die Interaktion mit Kafka erheblich erleichtert. Wenn Sie Kafka regelmäßig nutzen, lohnt sich ein Test auf jeden Fall!"
Data Analyst, Opalean
"Conduktor hilft mir täglich dabei, alle meine Kafka-Topics im Blick zu behalten. Die Abläufe laufen reibungsloser, da wir Engpässe schnell erkennen können. Ich empfehle Conduktor uneingeschränkt – der Effekt auf den täglichen Betrieb ist enorm."
Data Scientist, Intelligent Locations
Gefällt Ihnen Conduktor? Teilen Sie Ihre Erfahrungen auf G2
Was sind die Systemanforderungen?
Console benötigt mindestens 2 CPU-Kerne, 3 GB RAM und 5 GB Festplattenspeicher. Conduktor Gateway, unser Kafka-Proxy, benötigt 2 CPU-Kerne und 4 GB RAM. Beide erfordern Kafka 2.5.0 oder höher.
Ist ein Internetzugang erforderlich?
Nein, Sie können Conduktor in Air-Gap-Umgebungen betreiben. Die Docker-Images funktionieren ohne Internetzugang.
Welche Datenbanken benötigt Conduktor?
Eine externe PostgreSQL 13+-Datenbank für Konfiguration, Benutzer und Berechtigungen. Für das Monitoring können Sie optional S3, GCS oder Azure Blob Storage konfigurieren.
Wie lange dauert die Einrichtung?
Der Quick-Start-Befehl stellt einen vollständigen Stack in weniger als 5 Minuten bereit. Produktions-Deployments dauern typischerweise 1–2 Stunden, abhängig von Ihrer Infrastruktur.
Gibt es einen kostenlosen Tarif?
Ja, Conduktor bietet einen kostenlosen Tarif für Einzelpersonen und kleine Teams. Weitere Informationen finden Sie unter Preise.
Welche Kafka-Distributionen werden unterstützt?
Conduktor funktioniert mit jedem Kafka 2.5.0+, einschließlich Confluent Platform, Amazon MSK, Redpanda, Aiven und selbst verwaltetem Apache Kafka.
Zuletzt aktualisiert: Juni 2026